AENGDO / COMPUTER VISION EXPERIMENTS
Vision Lab
점 추적, 자세·신체 분할, 3D 모션과 인체·물체 복원.
실제 실행 결과와 모델별 준비 상태를 확인할 수 있습니다.
실행 결과10
일부 단계 실행01
실행 대기07
전체 기술18
실험 둘러보기 18
이미지를 눌러 실험을 열어보세요
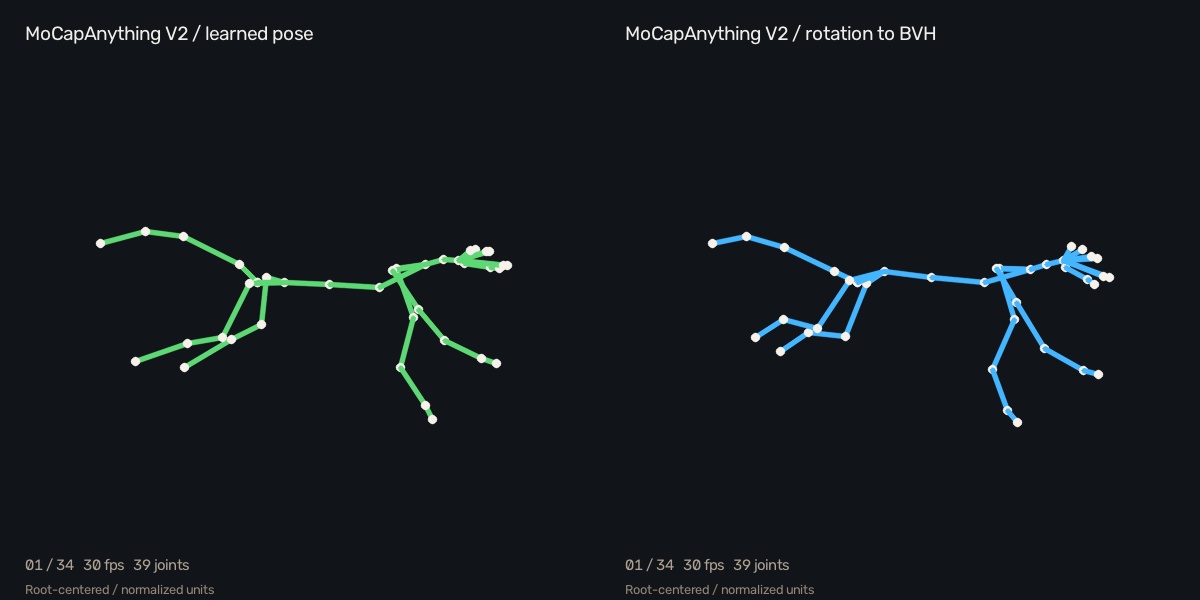 18 / VIDEO → POSE + ROTATION
MoCapAnything V2
영상과 기준 골격으로 관절 위치·회전을 추론했습니다. 입력 영상과 3D 골격을 함께 재생하고, 결과를 BVH로 내려받을 수 있습니다.
 17 / DATA + MODEL ACCESS REQUIRED
SOMA
대상자별 골격 자세로 피부와 근육의 시간에 따른 변형을 추정합니다. 공식 해부학 레이어 데모를 연결하고, SKIM v2 기반 재현 조건을 정리했습니다.
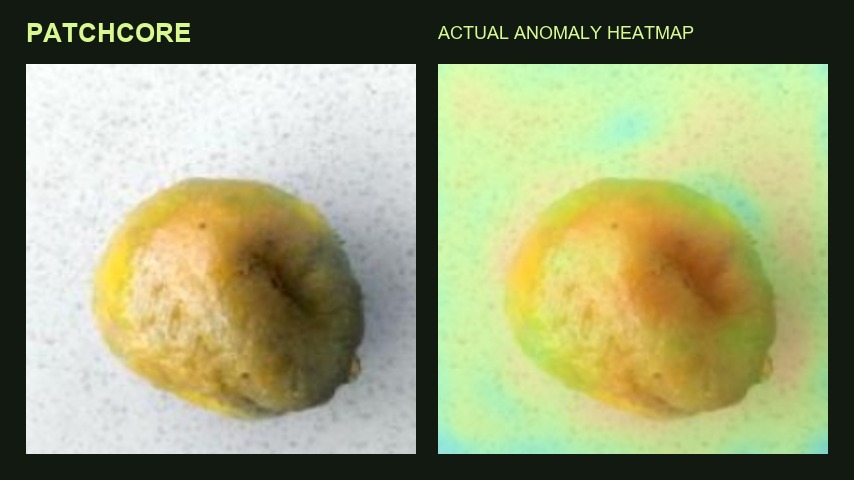 16 / NORMAL-ONLY ANOMALY DETECTION
PatchCore
정상 오렌지로 학습한 이상 점수·히트맵과 놓친 사례를 확인합니다. 실제 선별 라인 영상에는 RF-DETR·ByteTrack과 연속 프레임 판정을 연결했습니다.
 15 / COMPARISON PREPARATION
S4VY
같은 춤 영상의 신체 분할과 점 추적을 비교하고, S4VY에 사용할 대상 선택점을 기록합니다. S4VY 자체 추론은 공식 코드 공개 대기 중입니다.
 14 / CODE RELEASE PENDING
Dense4D
몸·옷·머리카락의 표면을 프레임 사이에서 대응시킵니다. 공식 3D 데모를 살펴볼 수 있으며, 자체 추론은 코드·가중치 공개 대기 중입니다.
 06 / 2D POINT TRACKING
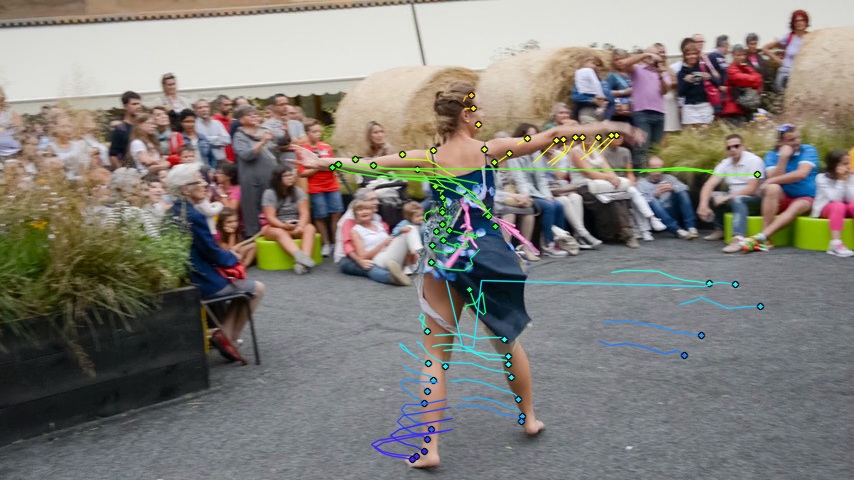
TAPNext++
춤·기차 영상의 같은 표면 점을 추적합니다. 원본과 궤적을 함께 재생하고 이탈한 점도 확인합니다.
 07 / POSE / BODY SEGMENTATION
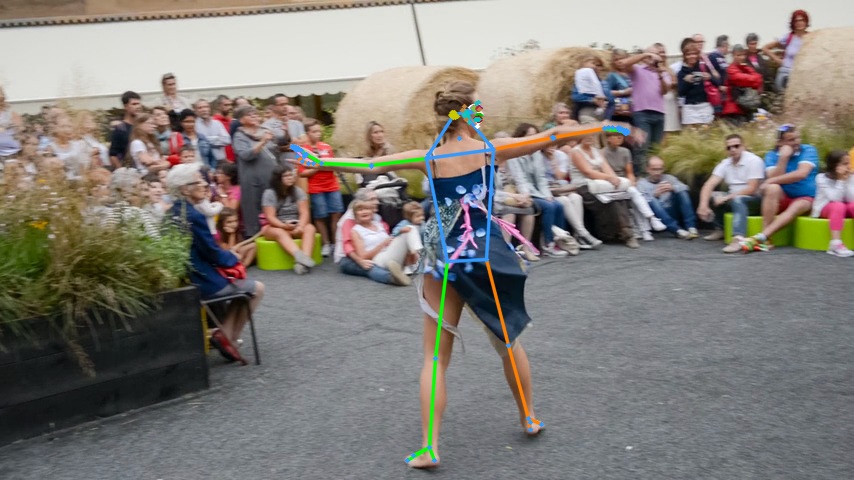
Sapiens2
춤 영상에서 308개 키포인트와 29개 분할 클래스를 추정했습니다. 키포인트·신체 부위 결과를 선택해 비교합니다.
 08 / MOTION REFINEMENT
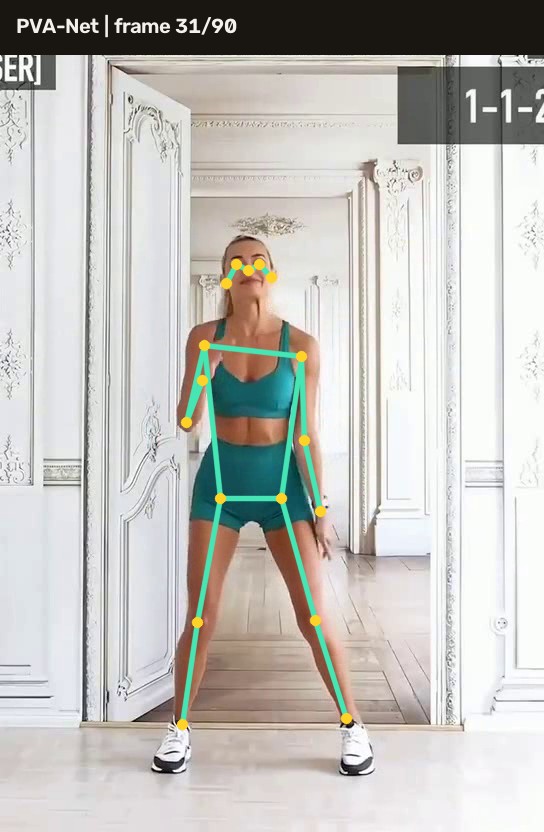
HTD-Refine
PVA-Net으로 관절 위치·속도·가속도를 추정합니다. 최종 인체 메시 보정에는 별도 SMPL-X 모델이 필요합니다.
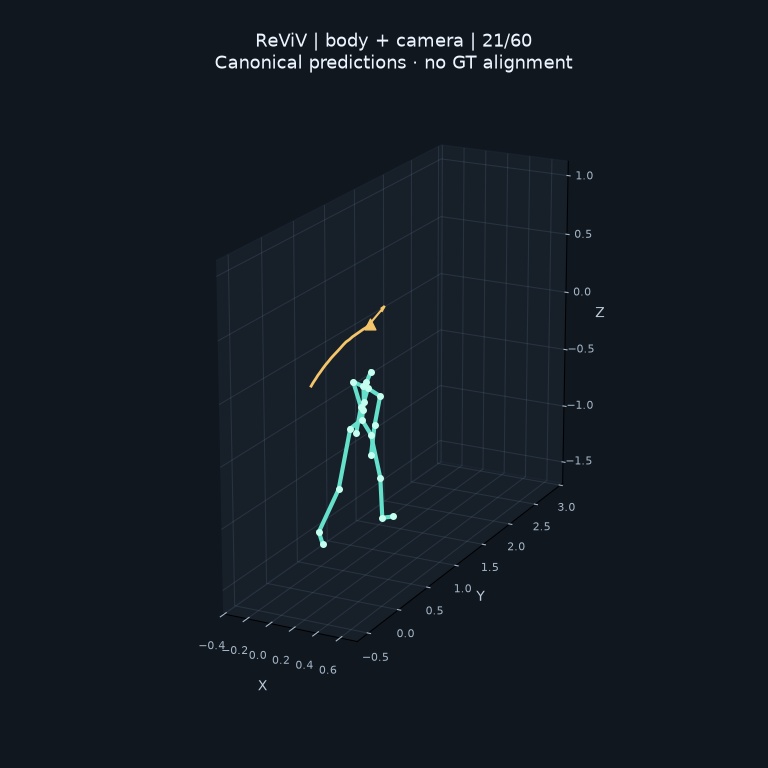 09 / EGOCENTRIC 3D MOTION
ReViV
1인칭 영상으로 촬영자의 몸·손·시선·깊이를 복원하는 실험입니다. 공식 256 해상도 모델을 사용합니다.
 10 / AWAITING MODEL ACCESS
4DAnyone
한 사람의 영상으로 여러 시점의 영상을 생성합니다. 관측되지 않은 모습은 생성 모델의 추정입니다.
11 / AWAITING MODEL ACCESSSAM 3.1
텍스트로 지정한 사람이나 물체를 마스크와 ID로 추적합니다. 공식 가중치 접근 승인 후 실행할 수 있습니다.
12 / AWAITING MODEL ACCESSFast SAM 3D Body
이미지에서 손·발을 포함한 인체 메시를 추정하는 가속 모델입니다. 기반 모델 접근 승인 후 실행할 수 있습니다.
13 / AWAITING MODEL ACCESSCARI4D
사람이 물체를 잡고 움직이는 장면에서 인체·물체의 3D 동작을 복원합니다. SMPL-H 모델이 필요합니다.
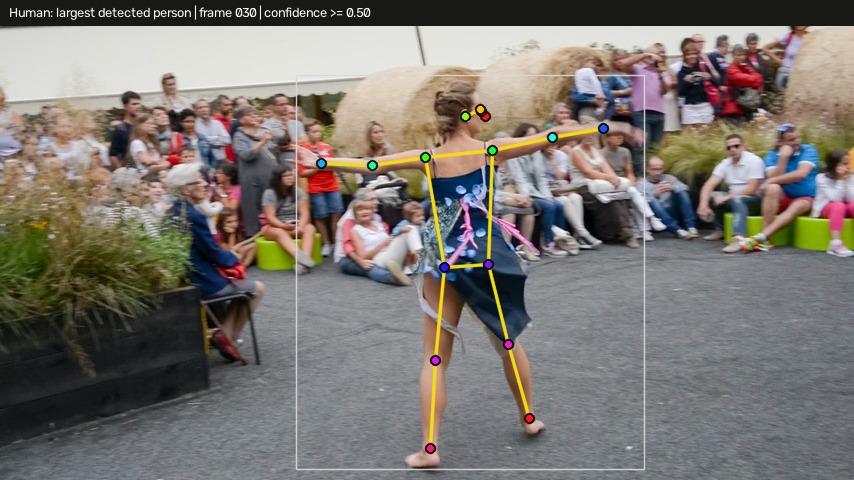 05 / DEEPLABCUT
DeepLabCut
춤과 쥐 영상에서 사전학습 모델을 실행했습니다. 관절 위치와 대상 선택 오류를 원본 영상과 비교합니다.
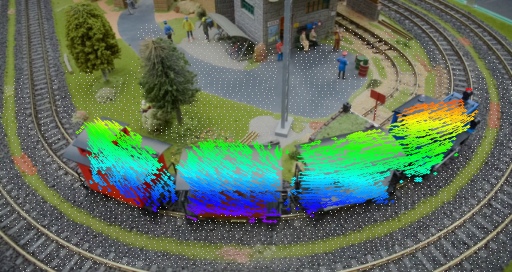 04 / 3D POINT TRACKING
TraceAnything
기차·춤 영상의 3D 추정 궤적을 영상 위 투영과 회전 가능한 점군으로 비교합니다.
 03 / PERCEPTION → CONTROL
MotionCheck V2
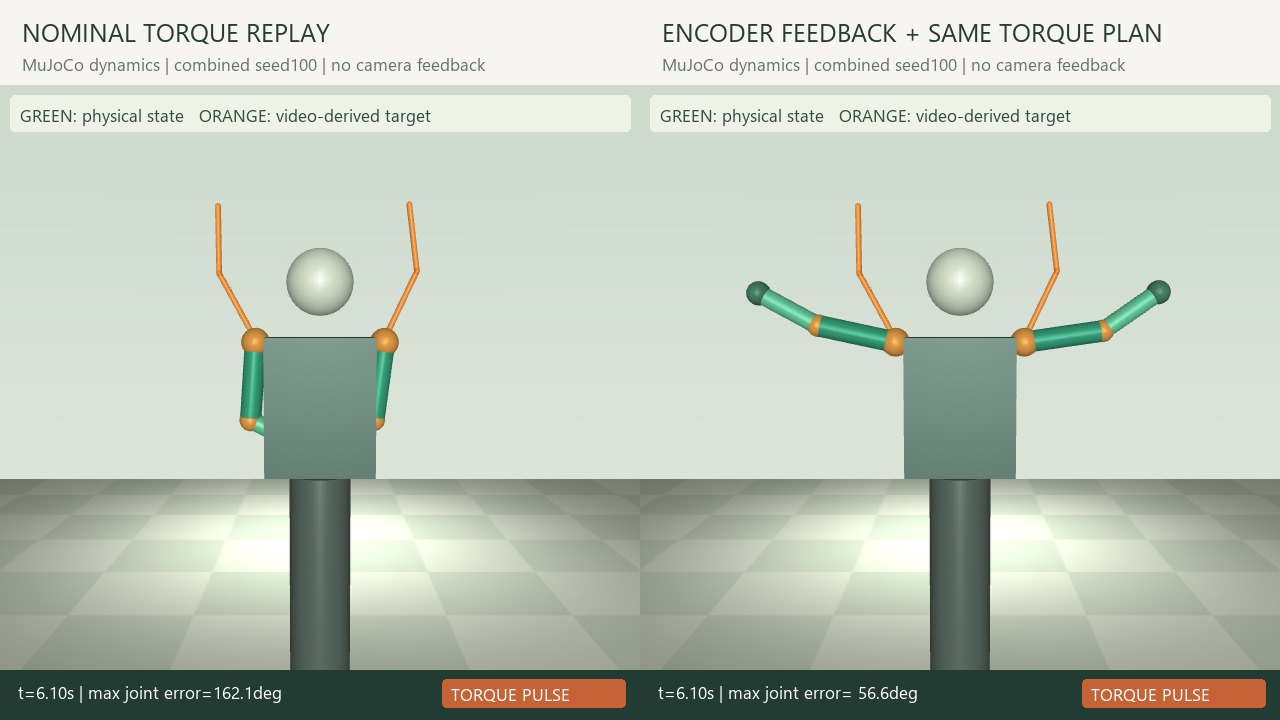
영상의 동작 단계를 판정하고, 팔 관절의 목표 자세와 MuJoCo 피드백 제어 결과를 비교합니다.
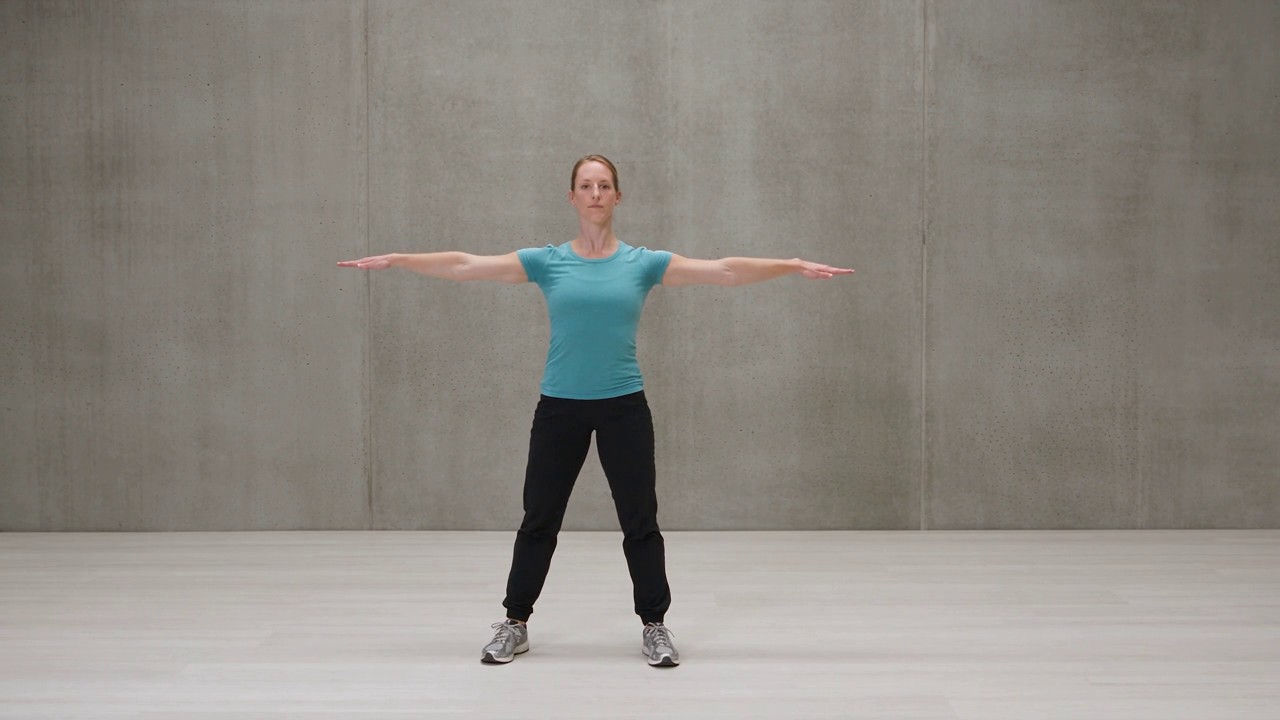 02 / HUMAN MOTION
MotionCheck V1
기준 영상과 수행 영상의 시간을 맞추고 2D 관절 좌표로 자세, 순서와 속도 차이를 비교합니다.
 01 / OBJECT RELATIONS
RelateAnything
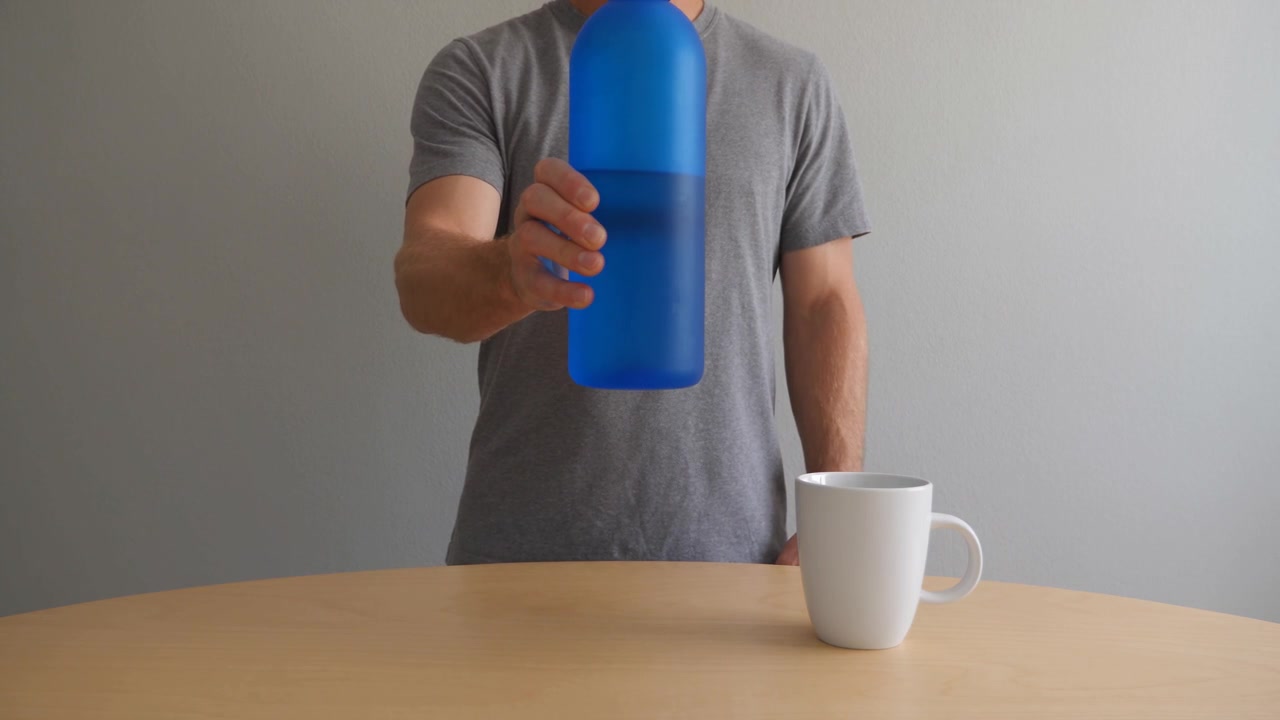
검출 분류가 바뀐 병을 같은 객체로 연결하고, 객체 연결 전후의 관계 점수와 시간 후처리를 비교합니다.