MOTIONCHECK / V2 / OBSERVE → VERIFY → CONTROL
동작을 비교하는 것에서
순서를 검증하고 제어하기까지
실제 영상에서 드러난 관측 실패와 물리 시뮬레이터의 잔여 제어 실패를 함께 공개한다. 영상의 순서 진단과 시뮬레이터의 토크 제어는 별개의 검증이다.
01 / FROZEN HUMAN CASES
실제 수행 3명분, 촬영 원본 2개
DVIDS 단체 운동의 중앙 인물을 참조로 사용했다. 다른 우측 인물과 별도 Commons 촬영의 수행이 두 번 팔을 올리는지 비교한다. 같은 Commons 수행의 뒤쪽 구간과 편집 대조군을 더해 총 8개 비교다. 8명의 독립 피험자나 8번의 독립 촬영이 아니다.
요구 순서는 팔 내림 → 팔 올림 → 팔 내림 → 팔 올림 → 팔 내림. 어깨·팔꿈치·손목을 비교하며 골반과 어깨는 정규화 기준이다. 다리·점프·착지의 정확성은 이 판정에 포함하지 않는다.
| 사례 | 초안 라벨 | 고정된 결과 | 부분 단계 관측 | 후보 관측률 |
|---|---|---|---|---|
| DVIDS 우측 인물: 두 번의 팔 올리기 | 양성 초안 | 판정 보류 | 4/5 | 93.9% |
| 별도 촬영: 두 번의 팔 올리기 | 양성 초안 | 판정 보류 | 3/5 | 100.0% |
| 같은 Commons 수행의 뒤쪽 두 반복 | 양성 초안 | 판정 보류 | 3/5 | 100.0% |
| 실제 비수행 구간: 손을 허리에 두고 서 있기 | 음성 초안 | 판정 보류 | 1/5 | 27.3% |
| 한 번만 수행: 후반 반복을 잘라낸 대조군 | 음성 초안 | 판정 보류 | 3/5 | 100.0% |
| 한 번만 수행: 별도 촬영의 후반 반복 잘라내기 | 음성 초안 | 판정 보류 | 2/5 | 100.0% |
| 중간 내려오기 삭제: 편집 대조군 | 음성 초안 | 판정 보류 | 3/5 | 100.0% |
| 내린 팔 정지: 반복 프레임 대조군 | 음성 초안 | 판정 보류 | 3/5 | 100.0% |
부분 단계가 관측되어도 참조가 관측 가능한 계약을 만들지 못하면 전체 판정은 UNKNOWN이다. 모든 라벨은 추론 전 assistant 시각 초안이며 전문가 운동 평가가 아니다.
기준 관측, 후보 관측률, 단계당 연속 관측 시간과 순서를 확인하고 선택된 후보 표본을 여러 필수 단계에 재사용하지 않는다. 관측 불가 표본은 보류 검사에 반영하지만, 표본 사이의 가림이나 행 자체가 없는 공백을 놓칠 수 있다. 아래 구현 감사에 반례를 기록했다.
POST-HOC REPAIR / UNSUCCESSFUL
같은 데이터에서 시도한 수정도 양성을 놓쳤다
참조 추출 실패를 본 뒤 의미 기반 팔 높이 조건을 추가했다. 아래 결과는 같은 영상을 다시 사용한 개발 분석이며 독립 평가 성능이 아니다. 원래 8개 판정 보류 결과는 그대로 보존했다.
| 사례 | 초안 기대 | 후속 결과 | 단계 |
|---|---|---|---|
| DVIDS 우측 인물: 두 번의 팔 올리기 | positive | 요구 미충족 | 1/5 |
| 별도 촬영: 두 번의 팔 올리기 | positive | 요구 미충족 | 3/5 |
| 같은 Commons 수행의 뒤쪽 두 반복 | positive | 요구 미충족 | 0/5 |
| 실제 비수행 구간: 손을 허리에 두고 서 있기 | negative | 판정 보류 | 1/5 |
| 한 번만 수행: 후반 반복을 잘라낸 대조군 | negative | 요구 미충족 | 3/5 |
| 한 번만 수행: 별도 촬영의 후반 반복 잘라내기 | negative | 요구 미충족 | 2/5 |
| 중간 내려오기 삭제: 편집 대조군 | negative | 요구 미충족 | 1/5 |
| 내린 팔 정지: 반복 프레임 대조군 | negative | 요구 미충족 | 1/5 |
IMPLEMENTATION AUDIT
추가 구현 점검에서 남은 네 가지 한계
샘플링에서 건너뛴 원시 프레임의 가림은 관측률과 유지 시간에 반영되지 않을 수 있다. 서로 다른 단계 이름이 같은 기하 자세를 가리키면 지속된 한 자세도 여러 단계로 세어질 수 있다. 행 자체가 없는 타임스탬프 공백은 명시적 unknown으로 채워지지 않으며, 외부 입력의 중복 프레임 ID도 검증하지 않는다.
따라서 이 구현의 관측률과 유지 시간은 샘플 행 기준이다. 현재 추출기는 연속 시각과 고유 ID를 생성하지만, 일반적인 드롭 프레임 스트림까지 검증한 것은 아니다. 이 반례를 확인한 뒤 고정 결과를 소급 수정하지 않았다. 합성 반례 원시 결과와 ZIP의 감사 기록을 함께 공개한다.
02 / DEVELOPMENT REGRESSION
이전에 본 21개 사례에서의 변화
v1의 21개 결과는 v2를 개발할 때 이미 본 자료다. 이 표는 개발 회귀 검사이며 새로운 사람에 대한 일반화 지표가 아니다. 합성 영상의 중간 단계 생략은 요구 미충족으로 바뀌었지만, 짧은 실제 Floss 영상은 참조 단계가 너무 짧아 모두 판정 보류다. 과거의 오판 4개를 모두 해결했다고 주장하지 않는다.
| 사례 | 그룹 | v1 | v2 | 단계 |
|---|---|---|---|---|
| 원본 동일 입력 | real_dance | aligned | unknown | 7/9 |
| 전체 속도 1.35배 느리게 | real_dance | aligned | unknown | 9/9 |
| 구간별 속도 변화 | real_dance | aligned | unknown | 6/9 |
| 동작 구간 순서 교환 | real_dance | aligned | unknown | 7/9 |
| 중간 동작 생략 | real_dance | aligned | unknown | 4/9 |
| 중간 프레임 정지 | real_dance | aligned | unknown | 6/9 |
| 좌우 반전 · 엄격한 좌우 대응 | real_dance | unknown | unknown | 5/9 |
| 중간 구간 영상 소실 · 전체 검정 프레임 | real_dance | unknown | unknown | 3/9 |
| 원본 동일 입력 | generated_controls | aligned | meets_contract | 6/6 |
| 전체 속도 1.35배 느리게 | generated_controls | aligned | meets_contract | 6/6 |
| 구간별 속도 변화 | generated_controls | aligned | meets_contract | 6/6 |
| 동작 구간 순서 교환 | generated_controls | needs_review | incorrect | 5/6 |
| 중간 동작 생략 | generated_controls | aligned | incorrect | 5/6 |
| 중간 프레임 정지 | generated_controls | needs_review | incorrect | 5/6 |
| 좌우 반전 · 엄격한 좌우 대응 | generated_controls | needs_review | incorrect | 5/6 |
| 중간 구간 영상 소실 · 전체 검정 프레임 | generated_controls | unknown | unknown | 4/6 |
| 같은 지시, 별도 생성 영상 | independent_generated | aligned | meets_contract | 6/6 |
| 양팔 머리 위 · 일치 예시 | pose_cases | aligned | meets_contract | 1/1 |
| 한쪽 팔만 머리 위 | pose_cases | needs_review | incorrect | 0/1 |
| 양팔 수평 · 다른 자세 | pose_cases | needs_review | incorrect | 0/1 |
| 양팔 아래 · 다른 자세 | pose_cases | needs_review | incorrect | 0/1 |
03 / PHYSICAL TORQUE SIMULATION
영상 기반 목표각과 실제 관절 피드백
기존 합성 기준 영상의 2D 포즈를 네 개의 평면 팔 관절 목표각으로 변환했다. MuJoCo 3.13.0에서 관성·중력·감쇠를 가진 팔을 토크로 움직인다. FF-only는 명목 역동역학 토크를 재생하며, FF+PD는 이상적인 관절 센서의 오차를 사용해 같은 토크 제한 안에서 보정한다.
평가 전 지정한 복합 조건 seed100. 초록 팔은 실제 물리 상태이고 주황 선은 목표다. 평가는 목표 qpos를 실제 상태에 대입하지 않는다. 렌더링에서는 저장된 실제 궤적을 재생한다.
원래 평가: 4조건 × 20시드 × 2제어기 = 160개
| 조건 | FF-only RMSE | FF+PD RMSE | 완료 FF / FF+PD |
|---|---|---|---|
| 기본 모델 | 69.55° | 0.66° | 0/20 · 20/20 |
| 외란 토크 | 60.43° | 0.75° | 0/20 · 20/20 |
| 모터 출력 저하 | 56.27° | 2.31° | 0/20 · 20/20 |
| 출력·질량·감쇠 변화 + 외란 | 60.63° | 13.93° | 0/20 · 8/20 |
복합 조건의 FF+PD도 12/20개를 완료하지 못했다. 다섯 사전 지정 시간창마다 네 관절 오차가 12° 이내인 상태를 0.35초 관측해야 완료다. 평균 RMSE가 낮아지는 것과 전 구간 완료는 다르다.
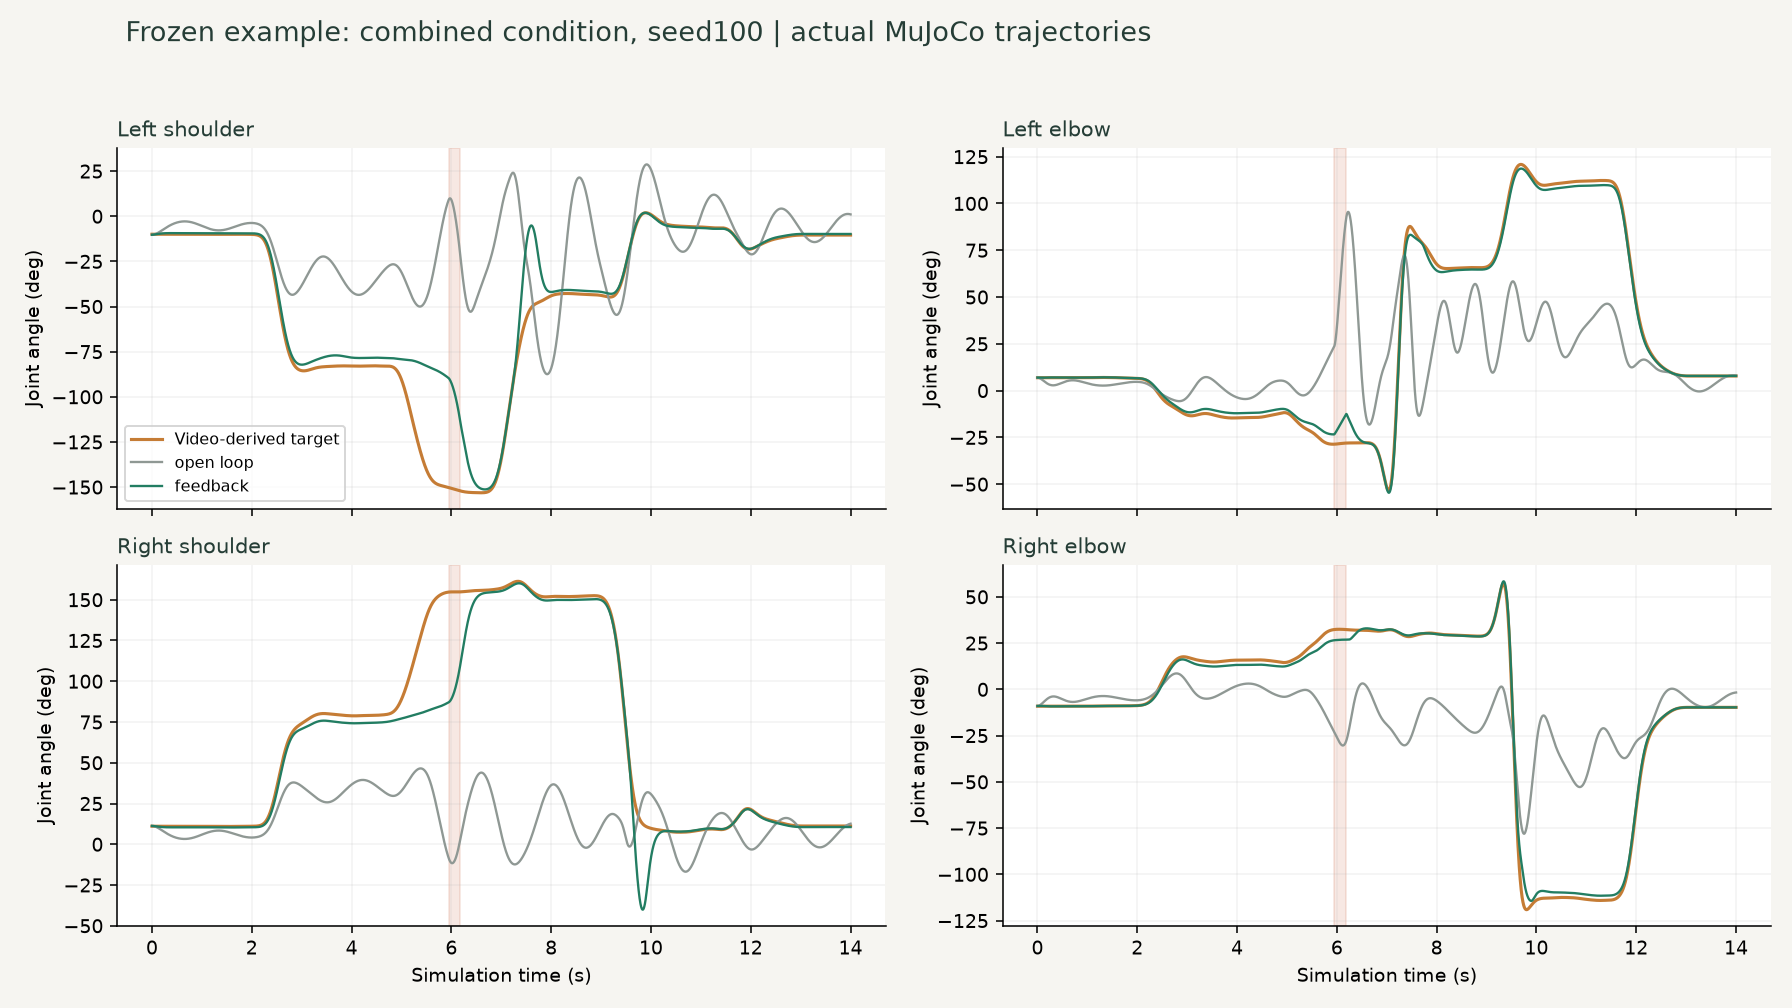
기준 토크 계획의 어깨 요구량은 약 14.90/19.29 Nm까지 올라가며 12 Nm 제한에 잘리는 구간이 있다. 따라서 큰 FF-only 오차는 약한 기준선, 예산 불충족과 상태 민감도를 포함한다. 이를 순수 외란 제거 효과나 강한 최적 제어기 대비 성능으로 해석하지 않는다.
04 / STRONGER BASELINE
같은 PD 이득에서 사전 토크 계획의 기여
초기 결과를 본 후 PD-only 기준선을 추가하고, 새 내부 시드 200–219를 실행하기 전에 별도로 고정했다. 모든 방법에 같은 제한과 외란을 사용했다. PD-only와 FF+PD의 PD 이득은 같고, PD-only는 사전 토크 표만 0이다. 각 제어기를 따로 최적화한 경쟁이 아니다.
| 조건 | FF-only RMSE | PD-only RMSE | FF+PD RMSE | 완료 FF / PD / FF+PD |
|---|---|---|---|---|
| 기본 모델 | 69.60° | 3.11° | 0.66° | 0/20 · 20/20 · 20/20 |
| 외란 토크 | 65.76° | 3.13° | 0.76° | 0/20 · 20/20 · 20/20 |
| 모터 출력 저하 | 56.25° | 4.75° | 2.31° | 0/20 · 20/20 · 20/20 |
| 출력·질량·감쇠 변화 + 외란 | 60.50° | 11.66° | 10.02° | 0/20 · 13/20 · 14/20 |
복합 조건에서 FF+PD의 RMSE는 PD-only보다 평균 1.632° 낮았다(짝지은 내부 시드 부트스트랩 95% 구간 1.299–1.964°). 완료는 13/20→14/20으로 1개 차이이며 완료율 차이 구간은 0–0.15다. 완료 성공률이 확실히 개선됐다고 주장하지 않는다.
총 400개는 같은 모형·같은 합성 기준 동작에 대한 내부 시뮬레이션 반복이다. 400명, 400개의 외부 동작이나 실제 로봇 검증이 아니다. 개발 60개는 이 수에 포함하지 않는다. 약 1 ms로 기록된 일부 복구값은 이미 허용 오차 안에 있던 상태의 다음 적분 표본 위치이며 복구 속도 성능으로 사용하지 않는다.
05 / REPRODUCIBILITY & SCOPE
재현 자료와 다음 검증
소스·클립·주석·원시 결과·물리 궤적 ZIP에는 frozen manifest, 9개 실제 클립, 8개 원래 결과, 실패한 사후 분석, 21개 개발 결과, 160개와 240개 에피소드, MuJoCo 장면·설정·대표 궤적을 포함했다. 모델 가중치, 계정 URL, 캐시와 69 MB 전체 원본은 제외했다.
영상 지각의 입력은 오프라인이다. 온라인 보정은 관절 센서 기반이며 카메라 기반 폐루프 제어가 아니다. 몸통은 고정되어 있고 접촉·충돌·다리·균형·손 조작은 범위 밖이다. 다음 단계는 더 선명한 정면 실제 영상, 전문가 이중 주석, 새 촬영에서의 동결 평가와 지연·가림이 있는 센서 검증이다.
기록된 GPU 시간은 클립의 decode·pose·postprocess 범위이며 파일 쓰기·웹 재생·전체 제어 지연을 포함하지 않는다. 본 보고서는 전체 온라인 FPS를 주장하지 않는다.
SOURCES & RIGHTS
출처와 재사용 조건
Fit for Duty: Calisthenics & Stretching, courtesy U.S. government / DVIDS, 2007. 공식 항목의 공개 도메인 표시와 이용 조건을 확인했다. 변경: 구간 선택·crop·오디오 제거·재인코딩; 명시된 대조군은 시간 편집도 포함한다.
The appearance of U.S. Department of War (DoW) visual information does not imply or constitute DoW endorsement.
Jumping jacks and burpees, Taco Fleur, 2017. CC BY-SA 4.0. 파생 클립도 같은 라이선스. 변경: 연속 trim·H.264 변환·오디오 제거, one-cycle 대조군은 두 번째 반복 삭제. 원저자의 보증이나 지지를 뜻하지 않는다.
연구 배경
- Temporal Cycle-Consistency Learning — Conceptual background; not reproduced.
- Learning by Aligning Videos in Time — Motivation only; a hand-built ordered matcher is not LAV reproduction.
- FineDiving: A Fine-Grained Dataset for Procedure-Aware Action Quality Assessment — 설계 배경. 학습 모델 재현 결과가 아님.
- CaptainCook4D: A Dataset for Understanding Errors in Procedural Activities — 설계 배경. 학습 모델 재현 결과가 아님.
- DeepMimic: Example-Guided Deep Reinforcement Learning of Physics-Based Character Skills — 설계 배경. 학습 모델 재현 결과가 아님.
- AMP: Adversarial Motion Priors for Stylized Physics-Based Character Control — 설계 배경. 학습 모델 재현 결과가 아님.
- MuJoCo Documentation: actuation model and MJCF actuators — 설계 배경. 학습 모델 재현 결과가 아님.
논문은 설계 배경이다. TCC·LAV·FineDiving·DeepMimic·AMP의 학습 정책이나 가중치를 실행한 비교 결과가 아니다.